Repérer les informations
Recherchez les noms, adresses, organisations, e-mails, téléphones, IBAN et cartes bancaires. Sélectionnez les suggestions à ajouter à votre aperçu.
De l’import à l’export, voici ce que fait l’application, ce qui reste sur votre ordinateur et pourquoi la copie ne contient plus les informations masquées.
Cette vidéo montre le caviardage manuel d’un document fictif dans l’application. Suivez les étapes, de l’import à l’export.
Ouvrir le PDF dans l’espace de travail.
Dessiner les rectangles sur les coordonnées.
Annuler une zone, puis ajuster la sélection.
Créer une nouvelle copie caviardée.
Vidéo sans audio, sous-titrée. Capture de l’interface web du projet ; dans l’application de bureau, l’export nécessite un compte et des crédits.
Un document fictif est importé. Trois rectangles sont dessinés sur le nom, l’e-mail et le téléphone. La dernière sélection est annulée, puis redessinée. Le projet et le montant restent visibles. Le bouton « Exporter le PDF » télécharge une nouvelle copie composée d’images avec les zones sélectionnées caviardées.
L’assistant vous propose des zones à masquer. Vous pouvez modifier ses propositions et vérifier chaque page avant l’export.
Recherchez les noms, adresses, organisations, e-mails, téléphones, IBAN et cartes bancaires. Sélectionnez les suggestions à ajouter à votre aperçu.
Choisissez les catégories à masquer pour préparer automatiquement le caviardage d’un document ou d’un lot. Relisez l’aperçu et annulez si nécessaire.
Écrivez « masque les noms et les coordonnées ». L’assistant propose les catégories d’informations à rechercher. Vous pouvez les modifier avant de lancer l’analyse.
Consultez les suggestions de l’assistant à côté du document et vérifiez les zones proposées sur chaque page. La reconnaissance de texte fonctionne aussi sur les documents numérisés, en français et en anglais.
L’IA et l’OCR peuvent manquer des informations ou proposer des zones trop larges. Votre relecture reste indispensable.
Voir la capture complète ↗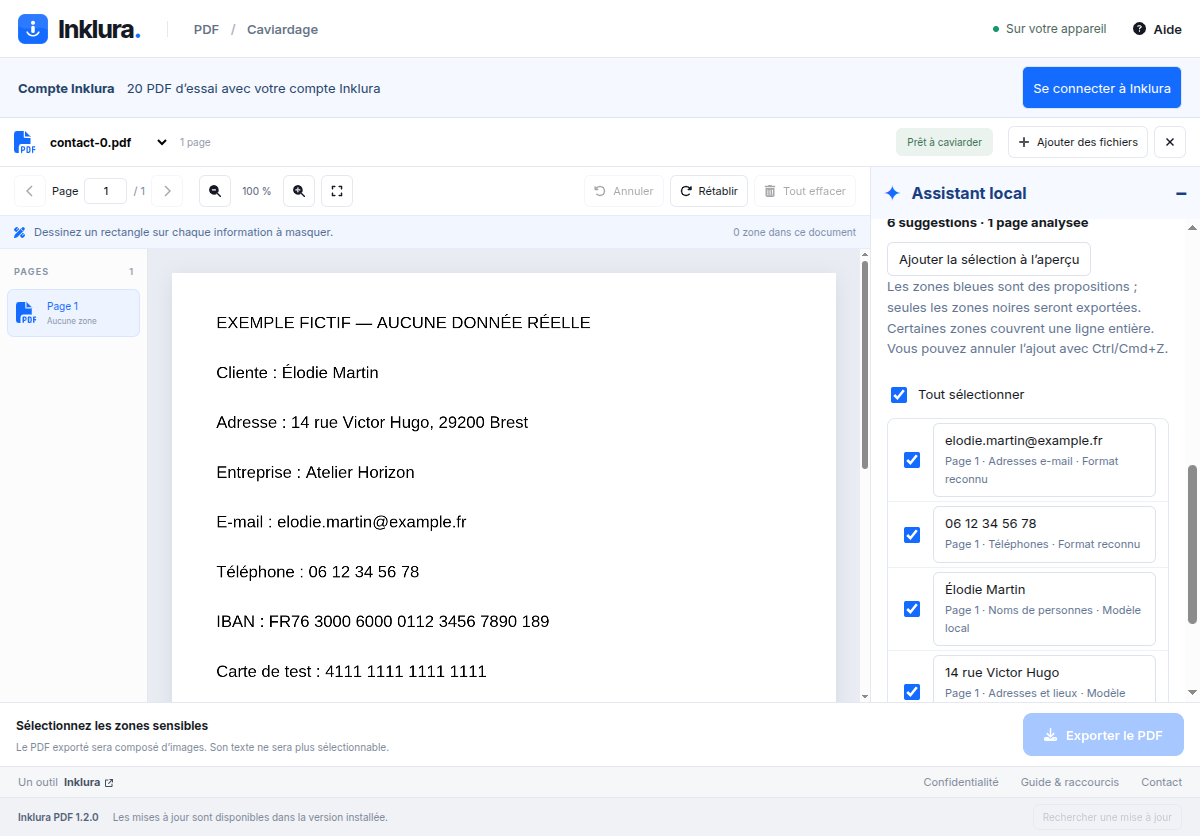
Vous souhaitez faire résumer un contrat ou analyser un dossier par une IA ? Ne conservez dans la copie que les informations nécessaires à votre demande.
Repérez les noms, coordonnées, signatures, références clients et autres informations confidentielles à retirer. L’assistant peut vous aider à les retrouver dans le document. Vérifiez chacune de ses propositions.
Un intitulé de poste inhabituel, une date précise ou le récit d’un événement peuvent suffire à identifier une personne. Relisez toutes les pages et choisissez un nom de fichier qui ne révèle pas son identité.
Exportez un nouveau PDF sans métadonnées documentaires, puis ouvrez-le pour le contrôler. Inklura PDF ne transmet aucun document à un service d’IA externe. Vous choisissez vous-même où envoyer la copie vérifiée.
Le traitement local évite de confier votre document original à un service d’IA pour le caviarder. Avant tout partage, assurez-vous d’être autorisé à transmettre les informations qui restent visibles. Consultez aussi les conditions de conservation et de réutilisation des données du service choisi.
La copie exportée est un PDF composé d’images. Pour en analyser le contenu, le service destinataire doit pouvoir lire les images ou utiliser la reconnaissance optique de caractères (OCR).
Les repères de la CNIL sur l’IA générative ↗Le caviardage supprime les zones choisies. L’anonymisation vise à empêcher l’identification d’une personne, y compris par recoupement. La suppression des noms ne suffit donc pas à garantir l’anonymat des personnes concernées.
Des données pseudonymisées restent des données personnelles. Inklura PDF vous aide à limiter les informations transmises. Son utilisation ne garantit pas, à elle seule, que le document est anonyme ou que son partage respecte le RGPD.
Comprendre l’anonymisation avec la CNIL ↗Le document reste local, du début à la fin.
Le caviardage, l’analyse et l’OCR s’exécutent sur votre ordinateur. Le mode manuel fonctionne sans télécharger de modèles.
Pour activer l’assistant, l’application télécharge une fois environ 1,18 Go de modèles. L’analyse fonctionne ensuite hors ligne. Les téléchargements de modèles et les recherches de mises à jour nécessitent Internet.
À l’export, Inklura PDF crée un nouveau PDF composé d’images : le contenu des zones choisies est supprimé, sans conserver le texte PDF, les annotations ou les pièces jointes de l’original. Le texte exporté n’est plus sélectionnable. Votre fichier original reste intact.
Comprendre l’export et le traitement des métadonnées ↓Lors de l’export, l’application reconstruit chaque page dans un nouveau fichier. Voici ce qu’elle conserve, ce qu’elle supprime et comment vérifier le résultat.
PDF.js dessine la page sur un canevas en mémoire, sur votre ordinateur. Toutes les pages sont reconstruites, même celles sans zone sélectionnée.
Les rectangles sont appliqués à cette image avant son incorporation au PDF. Les limites sont arrondies vers l’extérieur au pixel près pour couvrir la sélection.
pdf-lib crée un document neuf, avec une image PNG caviardée par page. Le contenu d’origine sous les zones noires n’est pas inclus dans cette nouvelle copie.
| Dans le PDF d’origine | Dans la nouvelle copie |
|---|---|
| Texte et couche OCR cachée | Aucun objet texte d’origine. Les mots visibles hors des zones caviardées restent lisibles dans l’image et peuvent être reconnus par un nouvel OCR. |
| Métadonnées et propriétés du document | Aucune propriété documentaire, date intégrée ou information sur le logiciel de création. Pas de dictionnaire Info, de flux XMP ni d’identifiant de document dans la copie. |
| Pièces jointes, scripts et actions PDF | Les fichiers incorporés, les scripts JavaScript et les actions du document source ne sont pas transférés. |
| Formulaires, annotations et liens | Les objets interactifs sont retirés. Leur contenu visible peut toutefois apparaître dans l’image de la page. Vérifiez aussi le texte des champs, les commentaires affichés et les adresses imprimées. |
| Calques et objets d’origine | La copie contient le rendu aplati des pages, sans reprendre leurs calques, polices ou objets image source. L’aspect visible hors des zones choisies est conservé. |
| Original, nom du fichier et signatures | L’original reste intact. Le nom proposé reprend celui du fichier source avec « -caviarde » : renommez-le s’il contient une information sensible. Les signatures numériques d’origine ne sont pas conservées comme signatures valides. |
La suite de régression utilise des PDF fictifs contenant notamment du texte caché, des métadonnées, des formulaires et des pièces jointes. Elle contrôle les pixels noirs, l’absence de texte sélectionnable et d’annotations, ainsi que l’absence de métadonnées documentaires et d’identifiant PDF. La structure est aussi contrôlée : une image aplatie par page, sans les objets sensibles du document source.
Un audit complémentaire utilise pypdf et Poppler pour examiner les fichiers produits. Ces tests documentent le comportement attendu ; ils ne constituent pas une certification de sécurité.
Le nom du fichier et les dates affichées par votre système de fichiers ne sont pas des métadonnées intégrées au PDF. L’export ne supprime pas l’original, ses sauvegardes ou les copies déjà partagées. Il ne réalise pas d’effacement sécurisé du disque.
Le rendu atteint 144 points par pouce pour les pages de taille courante. Il est réduit pour les très grandes pages afin de limiter le canevas à 8 192 pixels sur son côté le plus long et environ 24 millions de pixels. Les dimensions visibles des pages sont conservées.
La copie est un PDF d’images : le texte n’est plus sélectionnable ni recherchable sans un nouvel OCR. La structure sémantique, les balises d’accessibilité et l’interactivité du document d’origine ne sont pas préservées. Vérifiez la lisibilité des petits caractères et des éléments graphiques.
Le rendu des pages, le caviardage, l’analyse IA et l’OCR s’exécutent sur l’ordinateur. Les modèles de l’assistant sont téléchargés avant leur première utilisation. Les documents ne sont pas envoyés à un service d’IA distant.
La connexion au compte, la gestion des crédits, le paiement, le téléchargement des modèles et les recherches de mises à jour utilisent Internet. Dans l’application de bureau, l’export nécessite un compte et des crédits disponibles.
Des documents fictifs pour essayer le caviardage et l’assistant local, y compris sur des pages numérisées ou pivotées.
L’essai en ligne caviarde la première page d’un PDF dans votre navigateur, sans l’envoyer.